OUT OF MEMORY
Materiał wygenerowany z użyciem AI muzyka: MiniMax-Music3 obraz: Qwen-Image 2.1 int8wideo: MiniMax H3 ref2va, turbo 8-stepgłos: VoxCPM2upscale: AetherScale ×2montaż: HyperFrames
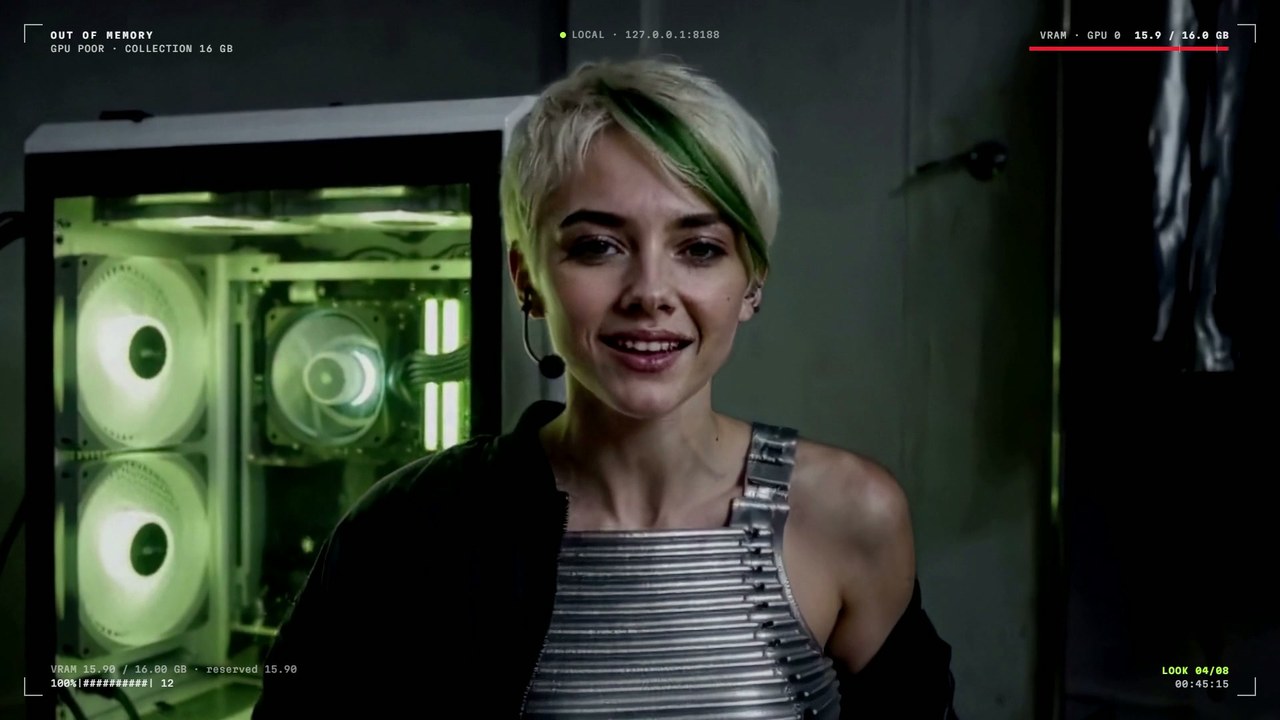
OUT OF MEMORY to lyric video w formie pokazu mody. Kolekcja nazywa się GPU POOR 16 GB, a każdy look to jedna z technik, dzięki którym duży model AI mieści się na domowej karcie graficznej. Look 02 to int8, czyli kwantyzacja: wagi modelu zapisane w 8 bitach zajmują o połowę mniej pamięci niż w 16 bitach. Look 03 to LoRA, mała nakładka wytrenowana na kilkudziesięciu zdjęciach, żeby model umiał odtworzyć konkretną twarz albo styl. W Looku 04 bohaterka zrzuca kurtkę, tak jak offload przerzuca część modelu z pamięci karty do zwykłego RAM-u.
W rogu kadru przez cały film rośnie licznik zajętej pamięci karty. W refrenach dobija do czerwieni, a w bridge’u pamięć się kończy i ekran zalewa błąd „CUDA out of memory”. Po komunikacie „Offloading to system memory” pokaz rusza dalej. Ostatni look nosi nazwę FULL PRECISION, a tablica odlotów przestawia się na TASTE · FP32 · FITS: skwantyzować da się wszystko oprócz gustu.
Jak powstał
Rano wyszedłem do biura, a agentowi Claude Code zostawiłem inne lyric video jako inspirację, wolną rękę i dostęp do mojego ComfyUI, programu, w którym uruchamiam modele AI na własnym komputerze. Z tamtego filmu agent przejął formę pokazu mody. Temat, utwór i bohaterka są nowe. Od tej chwili pracował sam. Wszystkie modele obrazu, dźwięku i wideo działały lokalnie, na jednej karcie RTX 5080 z 16 GB pamięci. W chmurze działał tylko sam agent.
- Agent napisał tekst po angielsku i wygenerował w MiniMax Music 3 kilka wersji piosenki. Nie słyszy, więc wybrał wersję na podstawie pomiarów: równego tempa, zrozumiałości słów i kompletności części utworu.
- W Qwen-Image zrobił casting bohaterki i przygotował kadry scenografii.
- Ujęcia ruchome to 21 klipów z MiniMax H3. W ujęciach ze śpiewem model dostawał wycinek wokalu z gotowego utworu i do niego generował ruch ust.
- Agent odczytał z utworu rytm i moment, w którym pada każde słowo. Na tej podstawie zbudował montaż i animacje w HyperFrames, gdzie grafikę pisze się w HTML i renderuje do wideo.
- Ostatnią linijkę mówi sklonowany głos wygenerowanej wokalistki, bo utwór z Music 3 kończył się na refrenie.
Film trwa 2:43. Pierwsza wersja końcowa powstała około 11 godzin po pierwszej wiadomości. Większość tego czasu zajęły dwie przerwy, kiedy agentowi skończył się limit w Claude. Karta w tym czasie kończyła zadania z kolejki. Sam agent pracował około dwóch godzin. Za generowanie nie zapłaciłem nic poza prądem.
Po powrocie obejrzałem film i zgłosiłem kilka uwag: napisy miejscami rozjeżdżały się z wokalem, czarny tekst ginął na czarnej kurtce, a do podnoszenia rozdzielczości wskazałem inne narzędzie. Poprawki też wprowadził agent. Film powyżej to wersja po poprawkach.
Co z tego wynika
- Klipy przypięte do utworu. Każdy klip powstaje do konkretnego fragmentu piosenki i ma w niej stałe miejsce, więc montaż może ciąć między ujęciami w dowolnym momencie. Synchronizację ust trzeba oceniać okiem, bo automatyczny pomiar okazał się niemiarodajny. Tą samą metodą da się zrobić teledysk albo spot ze śpiewającą postacią.
- Poprawki zajmują minuty. Wszystkie grafiki są wyliczane z rytmu i momentów, w których padają słowa. Przesunięcie słowa albo nowy klip to przebudowa w sekundę i render całego filmu w kilka minut. Moje uwagi trafiły do filmu jeszcze tego samego wieczoru.
- Wystarczyła jedna karta. Wszystkie modele użyte w filmie zmieściły się na tej samej karcie z 16 GB: od muzyki, przez obraz i wideo, po podnoszenie rozdzielczości i klon głosu. Najdłużej trwa generowanie wideo, około 5,5 minuty na 10 sekund materiału. Nowa wersja ujęcia kosztuje czas pracy karty i prąd, bez opłat za każdą kolejną próbę.