H3CHAL
Materiał wygenerowany z użyciem AI muzyka: MiniMax-Music3 ComfyUI (lokalnie)wideo: MiniMax H3 ref2vaklipy łączone w latencieupscale: SeedVR2 7B
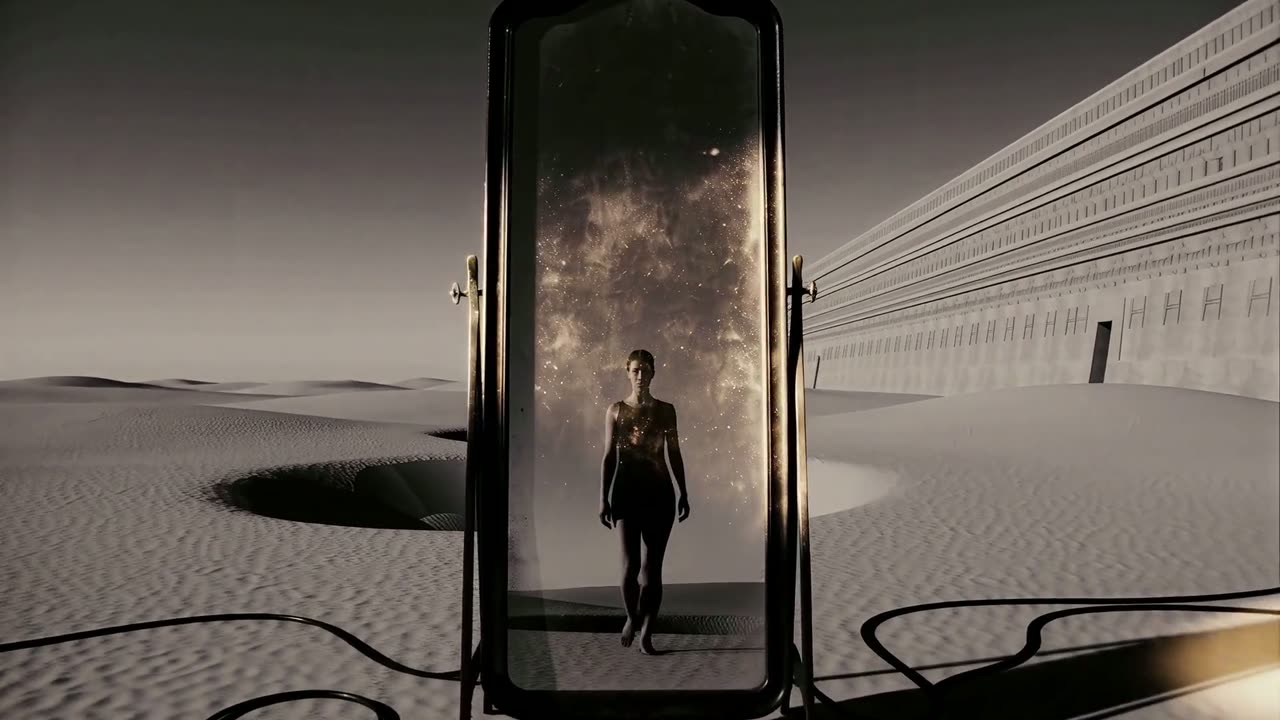
H3CHAL to 37-sekundowy teledysk zrobiony na konkurs Comfy H3 Sync Sound. Film to sen w czerni i bieli z ciepłym odcieniem sepii. Bose stopy idą po deskach nad czarną przepaścią, potem mijają nogi przechodniów i idą ceglanym zaułkiem, aż za rogiem otwiera się pustynia z lejami w piasku i ścianą rzeźbionego kamienia na cały horyzont. W finale na piasku stoi lustro. Muzyka z MiniMax Music 3 to rytualny utwór zbudowany na bębnach i dronie, około 144 BPM, z kobiecym głosem, który w pół frazy przechodzi z języka na język.
Jak powstał
Obraz oparłem na moim śnie: idę brudną, ciasną uliczką jak z komiksu noir, za rogiem jest pustynia, ja jestem maleńki, w piasku są leje, a dalej świątynia wykuta w górze, która zajmuje cały horyzont. Opowiedziałem go agentowi Claude Code, a przy kolejnych wersjach pilnowałem dwóch zasad: wszystko widzimy oczami śniącego, a sceny przechodzą jedna w drugą przez pęknięcie rzeczywistości. Wcześniej, przy utworze, chciałem kobiecego głosu i tekstu, w którym prawie każde słowo jest w innym języku.
Agent pisał prompty, czyli opisy ujęć dla modelu, tekst utworu i skrypty, mierzył dźwięk i składał kolejne wersje. Było ich kilkanaście. Oceniałem je okiem i uchem. Odrzuciłem pierwszą wersję z motywem Alicji w Krainie Czarów, bo była „z innej bajki”, i wersję, w której głównym tematem zrobiły się stopy. Poprosiłem o świątynię w skali, której ludzki umysł nie obejmie.
Ostateczną wersję wygenerowałem sam, jednym przebiegiem workflow do teledysków w ComfyUI, na którym wcześniej pracował agent. MiniMax H3, model wideo generujący obraz razem z dźwiękiem, tworzy w nim film klip po klipie, a każdy klip dostaje końcówkę poprzedniego w latencie, czyli w wewnętrznej, skompresowanej postaci materiału. Utwór też był wpisany w latent, więc obraz powstawał od razu do muzyki. Generowałem w 0,5 MP (960 na 544 piksele). Potem zmniejszyłem obraz o połowę, a SeedVR2, model do podnoszenia rozdzielczości wideo, który dorabia detal spójnie między klatkami, powiększył go czterokrotnie, do 1920 pikseli szerokości.
Co z tego wynika
- Utwór wpisany w latent. W wersjach roboczych utwór podany modelowi jako zwykła referencja wracał zniekształcony i w każdym klipie z innym opóźnieniem. Usłyszałem, że na łączeniach coś jest nie tak. Agent to zmierzył i znalazł sposób: wpisać utwór wprost w latent i osłonić maską, żeby model go nie zmieniał. W jego pomiarze zgodność ścieżki z oryginałem (w skali od 0 do 1) wzrosła z 0,728 do 0,964.
- Rozdzielczość na końcu. Ten sam film w 1 MP generował się prawie pół godziny, a w 0,5 MP 11 minut. Zwykłe narzędzia do powiększania obrazu poprawiają każdą klatkę osobno, więc ziarno zaczyna migotać. SeedVR2 w teście podwoił ostrość i zachował treść kadru.